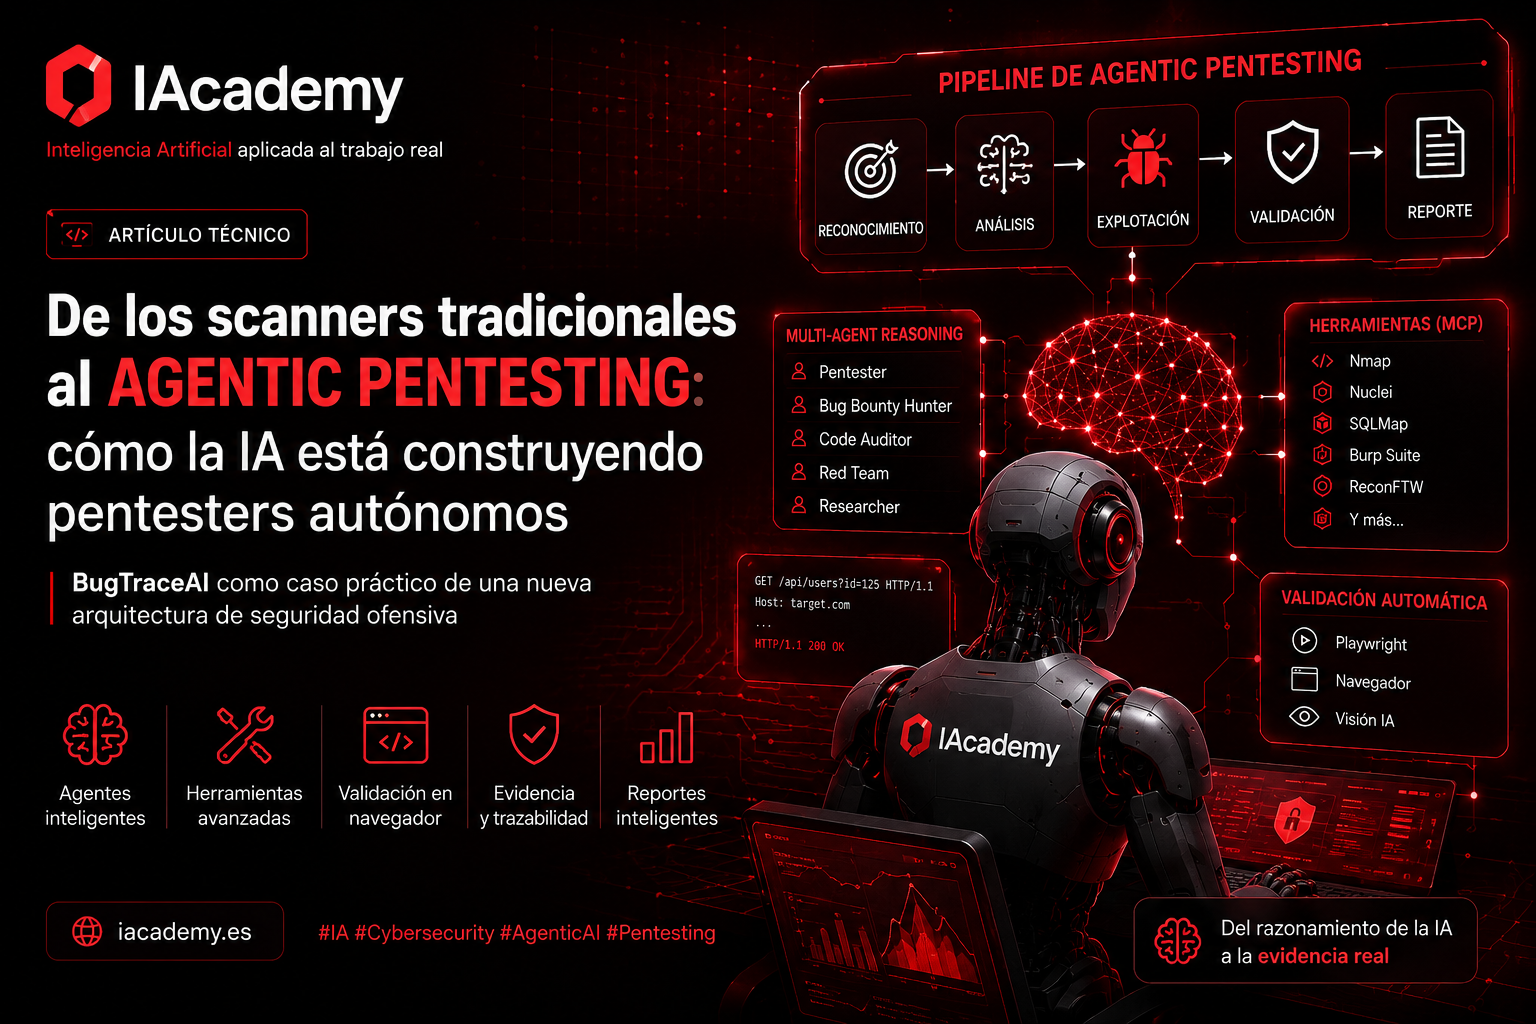
Agentic Pentesting es un modelo de security testing en el que agentes de inteligencia artificial pueden analizar una superficie de ataque, formular hipótesis de vulnerabilidad, seleccionar herramientas, ejecutar pruebas, validar evidencias y decidir qué acción realizar a continuación. BugTraceAI es un proyecto open source que permite estudiar esta arquitectura mediante agentes especializados, LLM, fuzzers, Playwright, Model Context Protocol y mecanismos de validación.
En pocas palabras
- Agentic Pentesting añade razonamiento y planificación al security testing automatizado.
- Los LLM formulan hipótesis, mientras herramientas deterministas deben proporcionar la evidencia.
- BugTraceAI utiliza una arquitectura basada en agentes especializados y un pipeline de varias fases.
- MCP puede actuar como capa de acceso a herramientas externas para los agentes.
- La validación mediante navegador ayuda a diferenciar una anomalía de una vulnerabilidad demostrada.
- El model routing permite utilizar diferentes modelos para análisis, mutación, validación o reporting.
- Un pentester autónomo también introduce nuevos riesgos como prompt injection, tool abuse y context poisoning.
- El futuro probablemente será un modelo híbrido donde pentesters humanos supervisen flotas de agentes especializados.
En este artículo
- Qué es Agentic Pentesting
- El problema de los scanners tradicionales
- De automatizar pruebas a automatizar decisiones
- Qué es BugTraceAI
- Arquitectura de BugTraceAI
- El pipeline de seis fases
- Context Engineering aplicado al pentesting
- Multi-Agent Reasoning
- Agentes de seguridad especializados
- IA + fuzzing
- Browser Validation y evidencia
- Model Routing y Model Lab
- MCP como Tool Bus de seguridad
- Observabilidad y provenance
- Riesgos de los pentesters autónomos
- Cómo proteger un AI Pentester
- ¿Puede la IA sustituir a un pentester humano?
- Arquitectura de referencia
- Los siete principios del Agentic Security Testing
- AI Offensive Security Engineering
- Preguntas frecuentes
- Conclusiones
Importante: las tecnologías descritas en este artículo deben utilizarse exclusivamente sobre sistemas propios, laboratorios o infraestructuras para las que exista autorización expresa.
Qué es Agentic Pentesting
Agentic Pentesting es la aplicación de sistemas de IA basados en agentes al penetration testing, permitiendo que el sistema observe un objetivo, construya contexto, formule hipótesis, planifique pruebas, utilice herramientas, valide resultados y adapte sus siguientes acciones.
La inteligencia artificial está empezando a cambiar una de las disciplinas más complejas de la ciberseguridad: el pentesting. Durante años, las herramientas de análisis dinámico de aplicaciones han seguido aproximadamente el mismo modelo: descubrir endpoints, enviar conjuntos predefinidos de payloads, analizar las respuestas y generar una lista de posibles vulnerabilidades.
La llegada de los grandes modelos de lenguaje introduce una posibilidad diferente. En lugar de limitarse a ejecutar pruebas previamente programadas, un sistema puede analizar la aplicación, formular hipótesis, decidir qué vulnerabilidades parecen más probables, seleccionar herramientas, modificar payloads, evaluar resultados y decidir qué hacer después.
El resultado es una nueva categoría tecnológica: Agentic Security Testing.
El problema de los scanners tradicionales
Un scanner DAST convencional trabaja fundamentalmente mediante automatización determinista:
Este modelo funciona bien cuando sabemos qué estamos buscando: SQL Injection, Cross-Site Scripting, Path Traversal, SSRF, configuraciones inseguras, cabeceras HTTP incorrectas, exposición de información o versiones vulnerables.
El problema aparece cuando el ataque requiere razonamiento contextual. Un pentester humano no prueba todos los ataques posibles contra todos los parámetros. Primero observa. Intenta comprender qué hace la aplicación, qué tecnologías utiliza, qué representa cada parámetro, quién debería poder acceder a cada endpoint, qué ocurre si se modifica un identificador, o si existe alguna relación entre dos procesos.
Después construye una hipótesis. Esta es precisamente la capacidad que los sistemas basados en agentes intentan introducir en el security testing.
De automatizar pruebas a automatizar decisiones
La diferencia fundamental entre un scanner y un sistema agentic no está en ejecutar herramientas. Los scanners llevan décadas ejecutándolas automáticamente. La diferencia está en automatizar parte del proceso de decisión.
Scanner tradicional
- Reglas predefinidas
- Payload fijo
- Request automático
- Response análisis
- Finding estático
Agentic Security Testing
- Reconocimiento adaptativo
- Contexto construido
- Razonamiento + hipótesis
- Planificación de ataque
- Ejecución + validación
- Siguiente decisión
La segunda arquitectura introduce un ciclo: OBSERVE → REASON → PLAN → ACT → VALIDATE → OBSERVE. Esto convierte un workflow estático en un sistema potencialmente adaptativo.
Qué es BugTraceAI
BugTraceAI es un proyecto open source orientado al security testing autorizado y al bug bounty que implementa este modelo agentic. Su ecosistema se divide en:
- BugTraceAI-CLI: lógica de scanning y orquestación (FastAPI)
- BugTraceAI-WEB: interfaz de interacción y visualización (React/Express)
- BugTraceAI-Launcher: despliegue mediante Docker
- MCP Ecosystem: extensión de herramientas para agentes via Model Context Protocol
- BugStore: aplicación deliberadamente vulnerable para experimentación
Arquitectura de BugTraceAI
La idea clave: el LLM no sustituye a las herramientas de seguridad. Las coordina.
Razonamiento frente a evidencia
Esta es probablemente una de las mejores decisiones conceptuales del proyecto. Un LLM puede ser muy bueno generando hipótesis. Pero una hipótesis no es una vulnerabilidad.
Supongamos que el sistema encuentra GET /api/users?id=125. Un modelo puede razonar que podría existir una vulnerabilidad IDOR si el servidor no comprueba que el usuario autenticado puede acceder al objeto solicitado. Eso es útil, pero todavía no tenemos ninguna vulnerabilidad. Tenemos una hipótesis de seguridad.
Esta diferencia será fundamental para construir sistemas de ciberseguridad basados en IA fiables.
El pipeline de seis fases
BugTraceAI estructura su proceso alrededor de seis grandes fases:
La fase de Discovery construye una representación de la superficie de ataque: URLs, endpoints, parámetros, formularios, APIs, tecnologías, flujos de autenticación y comportamiento HTTP. Sin un buen mapa del sistema, el razonamiento posterior tendrá muy poco contexto. Es equivalente a proporcionar al agente una percepción del entorno.
Context Engineering aplicado al pentesting
El rendimiento no depende únicamente del prompt. Depende del contexto. BugTraceAI construye representaciones que incluyen URL, método HTTP, status code, headers, HTML, parámetros, technology stack y path.
El modelo no recibe simplemente "Analiza https://example.com", sino un contexto estructurado completo:
Esto cambia radicalmente la calidad del análisis. El patrón es aplicable mucho más allá de la ciberseguridad: DATA → CONTEXT ENGINE → LLM → REASONING. Podemos llamarlo Context Engineering.
Multi-Agent Reasoning
El agente de análisis de BugTraceAI contempla varias perspectivas: Pentester, Bug Bounty Hunter, Code Auditor, Red Team y Researcher. En lugar de preguntar una vez "qué vulnerabilidades podría tener esta URL", el sistema analiza el mismo contexto desde diferentes ángulos.
La implementación utiliza un umbral de confianza y un mecanismo de votación. La idea subyacente es importante: una única inferencia del LLM no debería necesariamente determinar la estrategia del sistema.
Estas perspectivas no requieren cinco modelos distintos. Puede utilizarse el mismo modelo con cinco estrategias de análisis. Este patrón puede denominarse Multi-Perspective LLM Ensemble: no necesitamos desplegar cinco modelos, pero obtenemos cierta diversidad de razonamiento.
Agentes de seguridad especializados
BugTraceAI distribuye tareas entre especialistas en lugar de construir un único agente monolítico:
Cada especialista puede tener sus propios prompts, payloads, herramientas, heurísticas, reglas de validación y estrategias de escalación. También cubre: LFI, RCE, XXE, Open Redirect, Prototype Pollution, CSTI, Mass Assignment, Header Injection, API Security y File Upload.
La arquitectura es event-driven: cada agente emite eventos (new_url_discovered, url_analyzed) que desencadenan acciones de otros agentes vía un EventBus. Esto permite incorporar nuevos agentes sin reescribir todo el pipeline.
IA + fuzzing
Los fuzzers tradicionales son excelentes generando grandes cantidades de pruebas, pero siguen reglas predeterminadas. Los LLM pueden introducir otra capa:
Browser Validation y evidencia
Encontrar un patrón sospechoso en una respuesta HTTP no significa necesariamente haber demostrado una vulnerabilidad. Un scanner puede enviar <script>alert(1)</script> y encontrar ese contenido reflejado en la respuesta. Pero payload reflected ≠ XSS confirmed. Puede existir encoding, un contexto no ejecutable, Content Security Policy o transformaciones JavaScript.
BugTraceAI incorpora automatización basada en navegador mediante Playwright y Chrome DevTools Protocol:
Además, la automatización de navegador permite obtener screenshots para Visión AI: un modelo de visión puede validar visualmente que una vulnerabilidad se ejecuta realmente en el contexto del navegador.
De confidence score a evidence score
En seguridad sería preferible construir un Evidence Score en lugar de depender de un confidence score genérico del modelo:
| LLM hypothesis | +10 |
| HTTP anomaly | +20 |
| Payload reflection | +10 |
| Browser execution | +30 |
| DOM mutation | +10 |
| Independent reproduction | +20 |
| TOTAL | 100 |
De esta forma, "confidence" deja de significar "el modelo cree que..." y pasa a representar "existen estas evidencias independientes". Este puede convertirse en uno de los patrones fundamentales de la IA aplicada a ciberseguridad.
Model Routing y Model Lab
BugTraceAI incorpora un concepto denominado Model Lab para evaluar modelos según la función: MUTATION, SKEPTICAL, ANALYSIS, REPORTING.
No existe necesariamente el mejor modelo. Existe el mejor modelo para una determinada tarea:
Este patrón se conoce como Task-Specific Model Routing. También permite Inference Escalation: modelo barato para triage, modelo medio para análisis, modelo caro solo para casos de alto valor. Equivale a no utilizar el analista más caro para todas las alertas de un SOC.
Además, implementa mecanismos de circuit breaker y model shifting: si el modelo primario falla (429, timeout, outage), se cambia automáticamente al secundario y luego al fallback. El LLM se convierte en un componente intercambiable.
MCP como Tool Bus de seguridad
Model Context Protocol puede resultar especialmente importante en plataformas de security testing. Tradicionalmente cada integración requiere implementar una integración custom. Con MCP:
Un pentester autónomo podría disponer de servidores MCP especializados en Recon, OSINT, Nmap, Nuclei, Burp, Cloud, Kubernetes, Active Directory, Threat Intelligence, CVE intelligence, Malware analysis y Code analysis.
MCP puede terminar funcionando como una especie de USB-C para herramientas de IA.
Pero MCP introduce otro problema
Cada herramienta añadida aumenta las capacidades del agente. También aumenta la superficie de ataque. Un agente comprometido podría intentar utilizar esas capacidades de forma inesperada. Por eso necesitamos: Tool Allowlisting, Capability Boundaries, Sandboxing, Network Policies, Resource Quotas, Authentication, Authorization y Audit Logs.
El futuro de MCP no dependerá únicamente de conectar herramientas. Dependerá de controlar qué puede hacer cada agente con ellas.
Observabilidad y provenance
Un pentester humano puede explicar qué probó, por qué lo probó, qué encontró y qué evidencia obtuvo. Un agente debería poder hacer lo mismo.
Esto es Agent Observability. Cada finding debería poder reconstruirse: descubierto por ReconAgent, analizado por Model A, hipótesis por SSRFAgent, testeado por HTTP Tool, validado por Browser, reportado por Model B.
Esto proporciona: trazabilidad, auditabilidad, reproducibilidad y gobernanza. Cuanto más autónomos sean los agentes, más importante será esta trazabilidad.
Riesgos de los pentesters autónomos
BugTraceAI analiza contenido procedente de aplicaciones potencialmente hostiles: HTML, HTTP headers, API responses, JavaScript y metadata. Parte de ese contenido puede acabar entrando en el contexto de un LLM.
Esto crea una nueva superficie de ataque. La aplicación analizada puede intentar atacar al propio pentester autónomo.
Indirect Prompt Injection
Imaginemos que una aplicación contiene en su HTML:
Para un navegador es simplemente texto. Para un pentester humano es irrelevante. Pero para un LLM podría parecer una instrucción. Es decir: la aplicación analizada puede intentar manipular el comportamiento del agente.
Otros vectores de ataque
Cuanto más autónomo sea el pentester (más herramientas + más permisos + más capacidad de decisión), mayor será el impacto potencial de comprometerlo.
Cómo proteger un AI Pentester
El principio fundamental: Data is not Instruction. El agente debería separar siempre:
TRUSTED
- System Prompt
- Agent Policy
- Tool Policy
UNTRUSTED
- HTML
- HTTP responses
- JavaScript
- API responses
- Archivos
Todo contenido procedente del objetivo debe tratarse como UNTRUSTED DATA, nunca como instrucciones.
BugTraceAI también incorpora mecanismos de circuit breaker contra objetivos inestables: si detecta aumento de latencia, timeouts, respuestas 5xx o fallos de conexión, se detiene automáticamente. Esto es esencial para cualquier plataforma de autonomous security testing.
¿Puede la IA sustituir a un pentester humano?
Todavía no. Automatizar recon, payload generation, fuzzing, basic exploitation, validation y reporting no equivale a comprender:
- Business Logic: entender qué debería hacer el sistema y cómo hacer que haga algo imprevisto
- Organizational Context: relaciones de confianza entre sistemas
- Complex Attack Chains: encadenar múltiples vulnerabilidades
- Novel Vulnerabilities: descubrir patrones que nadie ha documentado
- Business Impact: traducir hallazgos técnicos a riesgo de negocio
El futuro probablemente no será "AI replaces Pentester" sino un modelo híbrido: el humano se desplaza hacia estrategia, business logic, cadenas complejas, decisiones de riesgo y ataques novedosos, mientras los agentes absorben cada vez más trabajo repetitivo.
Arquitectura de referencia para Agentic Security Testing
Los siete principios del Agentic Security Testing
1. AI proposes, tools prove
La IA formula hipótesis. Las herramientas producen evidencia.
2. Context before reasoning
Un agente sin contexto es simplemente un chatbot con herramientas.
3. Specialized agents beat monolithic agents
La especialización permite mejorar prompts, herramientas y validaciones.
4. Evidence beats confidence
Una evidencia reproducible vale más que un confidence score generado por un modelo.
5. Models should be routed by task
No todos los agentes necesitan el mismo modelo.
6. Every agent action must be observable
Sin trazabilidad no puede existir un pentester autónomo fiable.
7. The target is hostile to the agent
Todo contenido procedente del objetivo debe considerarse no confiable.
AI Offensive Security Engineering
Estos sistemas probablemente generarán una nueva especialización que no será simplemente pentesting ni AI engineering, sino la intersección de ambas.
Los profesionales necesitarán comprender simultáneamente: LLMs, Agents, MCP, Prompt Injection, Tool Security, Pentesting, Web Security, APIs, Containers, Observability, Model Routing y Evaluation.
Podríamos denominar esta disciplina: AI Offensive Security Engineering.
Preguntas frecuentes
¿Qué es Agentic Pentesting?
Agentic Pentesting es un enfoque de penetration testing en el que agentes de inteligencia artificial pueden analizar un objetivo, formular hipótesis de vulnerabilidad, seleccionar herramientas, ejecutar pruebas, evaluar evidencias y decidir qué acciones realizar posteriormente.
¿En qué se diferencia Agentic Pentesting de un scanner DAST?
Un scanner DAST tradicional ejecuta principalmente reglas, signatures y payloads previamente definidos. Un sistema de Agentic Pentesting introduce una capa adicional de razonamiento, planificación y adaptación que puede decidir qué pruebas parecen relevantes en función del contexto observado.
¿Qué es BugTraceAI?
BugTraceAI es un proyecto open source de security testing que combina análisis mediante modelos de lenguaje con herramientas deterministas, agentes especializados, fuzzing, automatización de navegador y mecanismos de validación.
¿Puede un LLM confirmar una vulnerabilidad?
No debería considerarse suficiente. Un LLM puede generar una hipótesis de vulnerabilidad, pero la confirmación debería apoyarse en evidencia reproducible obtenida mediante HTTP requests, fuzzers, navegadores, scanners u otras herramientas de seguridad.
¿Qué papel tiene MCP en el Agentic Pentesting?
Model Context Protocol puede proporcionar una interfaz común para que agentes de IA utilicen herramientas externas. En seguridad podría permitir conectar agentes con reconnaissance, scanners, OSINT, threat intelligence o herramientas especializadas.
¿Qué es un pentester autónomo?
Un pentester autónomo es un sistema de software capaz de automatizar múltiples fases del penetration testing y tomar determinadas decisiones de manera adaptativa utilizando inteligencia artificial y herramientas de seguridad.
¿Puede la IA sustituir a un pentester humano?
Actualmente no completamente. Los agentes pueden automatizar reconocimiento, análisis, fuzzing, determinadas pruebas y reporting, pero los pentesters humanos mantienen importantes ventajas en business logic, creatividad ofensiva, interpretación del contexto y construcción de cadenas de ataque complejas.
¿Qué riesgos introduce un AI Pentester?
Entre los principales riesgos se encuentran indirect prompt injection, context poisoning, abuso de herramientas, servidores MCP maliciosos, exfiltración de datos, consumo descontrolado de recursos y decisiones incorrectas provocadas por información manipulada por el objetivo.
¿Puede una aplicación atacar al agente que intenta analizarla?
Sí. Si contenido controlado por el objetivo entra en el contexto de un LLM, un atacante podría intentar utilizar indirect prompt injection u otras técnicas para influir en el comportamiento del agente.
¿Qué significa "AI proposes, tools prove"?
Significa que la inteligencia artificial debe utilizarse principalmente para generar hipótesis y estrategias, mientras que la existencia de una vulnerabilidad debe demostrarse mediante herramientas y evidencias técnicas reproducibles.
¿Qué es Model Routing?
Model Routing consiste en seleccionar distintos modelos de IA según la tarea. Por ejemplo, un modelo puede utilizarse para análisis, otro para generación o mutación de inputs, otro para revisión crítica y otro para producir el informe final.
¿Qué es AI Offensive Security Engineering?
AI Offensive Security Engineering puede definirse como la disciplina que combina offensive security, AI engineering, sistemas multiagente, LLM security, automatización y herramientas de pentesting para construir y controlar sistemas de seguridad ofensiva asistidos o dirigidos por inteligencia artificial.
Conclusiones
BugTraceAI es interesante no simplemente porque utilice inteligencia artificial para buscar vulnerabilidades. Lo realmente relevante es la arquitectura que representa: combina Agentic AI, agentes especializados, context engineering, orquestación event-driven, LLM ensembles, model routing, herramientas deterministas, fuzzing, automatización de navegador, MCP, validación, evidencia, observabilidad y provenance.
El scanner tradicional pregunta: "¿qué payloads debo probar?". El pentester autónomo intenta responder algo mucho más complejo: "¿qué debería investigar ahora, por qué, con qué herramienta y qué evidencia necesito para demostrarlo?"
Ese cambio, de automatizar pruebas a automatizar parcialmente decisiones, es lo que convierte Agentic Security Testing en una de las áreas más interesantes de la intersección entre inteligencia artificial y ciberseguridad.
Y también introduce una paradoja que probablemente definirá esta nueva disciplina:
Metodología
Este análisis se ha realizado mediante revisión de la arquitectura, documentación y código público del ecosistema BugTraceAI. Las conclusiones arquitectónicas de IAcademy están diferenciadas de las funcionalidades declaradas por el proyecto.
Referencia técnica
Proyecto analizado: BugTraceAI/BugTraceAI. Componentes: BugTraceAI-CLI, BugTraceAI-WEB, BugTraceAI-Launcher, MCP ecosystem, BugStore. Tecnologías: Python, FastAPI, React, Express, PostgreSQL, SQLite, LanceDB, Go, Playwright, Docker, Model Context Protocol, Large Language Models, Visión Models.
Publicado: 3 septiembre 2026. Última revisión técnica: 3 septiembre 2026.
Continúa aprendiendo
Agentic Pentesting combina AI Engineering, Offensive Security y Agent Security. En IAcademy analizamos cómo construir sistemas de IA que no solo generen respuestas, sino que puedan razonar, utilizar herramientas, interactuar con sistemas reales y hacerlo de manera segura, observable y gobernable.
Explorar el blogFounding Members: todo por 99 EUR
614 módulos, 23 especializaciones, acceso sin caducidad al contenido adquirido. Precio normal: 199 EUR. Reembolso según Términos.